この記事の監修者
この動画は当時の説明です。導入前後の数値だけではllms.txtの効果を確認できません。現在の判断と確認範囲は、本記事の更新内容をご覧ください。
現時点で、PENGINの過去の紹介内容だけから、llms.txtによって検索流入やAI引用が増えたとは確認できません。
従来の記事では、導入後のアクセス増加やAI引用率の変化を数値とともに紹介していました。しかし、今回の改稿では、比較期間、母数、質問セット、同時期の変更などを元データと再照合できていません。そのため、具体的な倍率や引用率を、検証済みの効果として再掲することは控えています。
この記事は新しい実験結果の報告ではなく、過去の説明を見直し、「何が確認でき、何が分からないか」を整理するものです。2026年9月時点で確認したGoogle公式情報も踏まえて、現在の判断を説明します。
ファイル設置より先に整えるべき情報はAI検索の対策|LLMO・AIOで比較候補に入るための情報設計で解説しています。効果が確認できなかった記録のような一次情報の扱いはAIに引用される一次情報の作り方をご覧ください。
llms.txtは、どの仕組みが使うかを分けて考える
llms.txtは、サイトの概要や関連文書へのリンクを、AIエージェントが利用しやすい形で案内する提案です。提案元は、必要な情報への入口としての用途を説明しています。設置しただけで、すべての検索・AIサービスが採用する仕組みではありません。
一方、Googleの生成AI最適化ガイドでは、Google Searchはllms.txtを使用せず、設置が検索の可視性や順位にプラスにもマイナスにもならないと説明されています。
したがって、現在のGoogle検索に向けて「llms.txtを置けば順位やAI機能での露出が上がる」と推奨することはできません。ただし、この説明をそのまますべてのAIエージェントに当てはめるのも違います。利用するシステムが明示的に対応しているなら、その用途で役立つかを別に確かめます。
LLMO全体で何を優先するかについては、BtoB企業のLLMOと情報整備の考え方で解説しています。
過去の記事では何を紹介していたか
以前の記事では、登壇者が個人で運営するWordPressのツール公開サイトにllms.txtを設置し、設置前後のユーザー数、検索での表示・クリック、AI回答内の引用について変化を紹介していました。
ここで注意したいのは、これはPENGINの顧客案件やコーポレートサイトで、条件をそろえて効果を確認した事例と同じではないことです。関連する基礎記事には複数サイトについての紹介もあり、対象と集計を区別する必要があります。
当時の数値の紹介と、「llms.txtが原因で増えた」という結論は分けます。現在の判断は、過去に変化がなかったと否定することではなく、その変化の原因をこの情報だけでは確定できないというものです。
前後で増えただけでは、なぜ効果を確定できないのか
別の変化が同時に起きていた可能性を切り分けられない
サイトの情報更新、検索需要、順位、参照されるページ、計測方法などが同時に変わっていれば、設置後の増加だけから原因を一つに絞ることはできません。
何も変更しなかった場合にどうなっていたかという比較も必要です。比較対象がない前後観測は、新しい仮説の手がかりにはなりますが、単独施策の効果を確定する根拠とは分けて扱います。
倍率だけでは、変化の規模と安定性が分からない
大きな倍率でも、元の件数が小さければ、少数の増減で値が大きく動きます。また、比較した日数が異なるなら、単純な合計ではなく同じ条件にそろえる必要があります。
必要なのは、元の件数、対象期間、指標の定義です。ユーザー数、セッション数、検索クリック数はそれぞれ別の指標なので、一つの「アクセス数」にまとめて効果を説明しないようにします。
引用率は、何を何回聞いたかで意味が変わる
AIへの質問に会社名を含めているのか、一般的な依頼先を尋ねているのかで、観測したいことは異なります。回答にURLが載った場合と、会社名だけが登場した場合も区別が必要です。
引用率を出すなら、質問群と試行数、引用の判定方法を先に決め、回答全文と出典を保存します。結果を見てから都合のよい質問だけを残す方法では、施策前後を公平に比較できません。
「設置・取得・利用・成果」の4つを分けて確認する
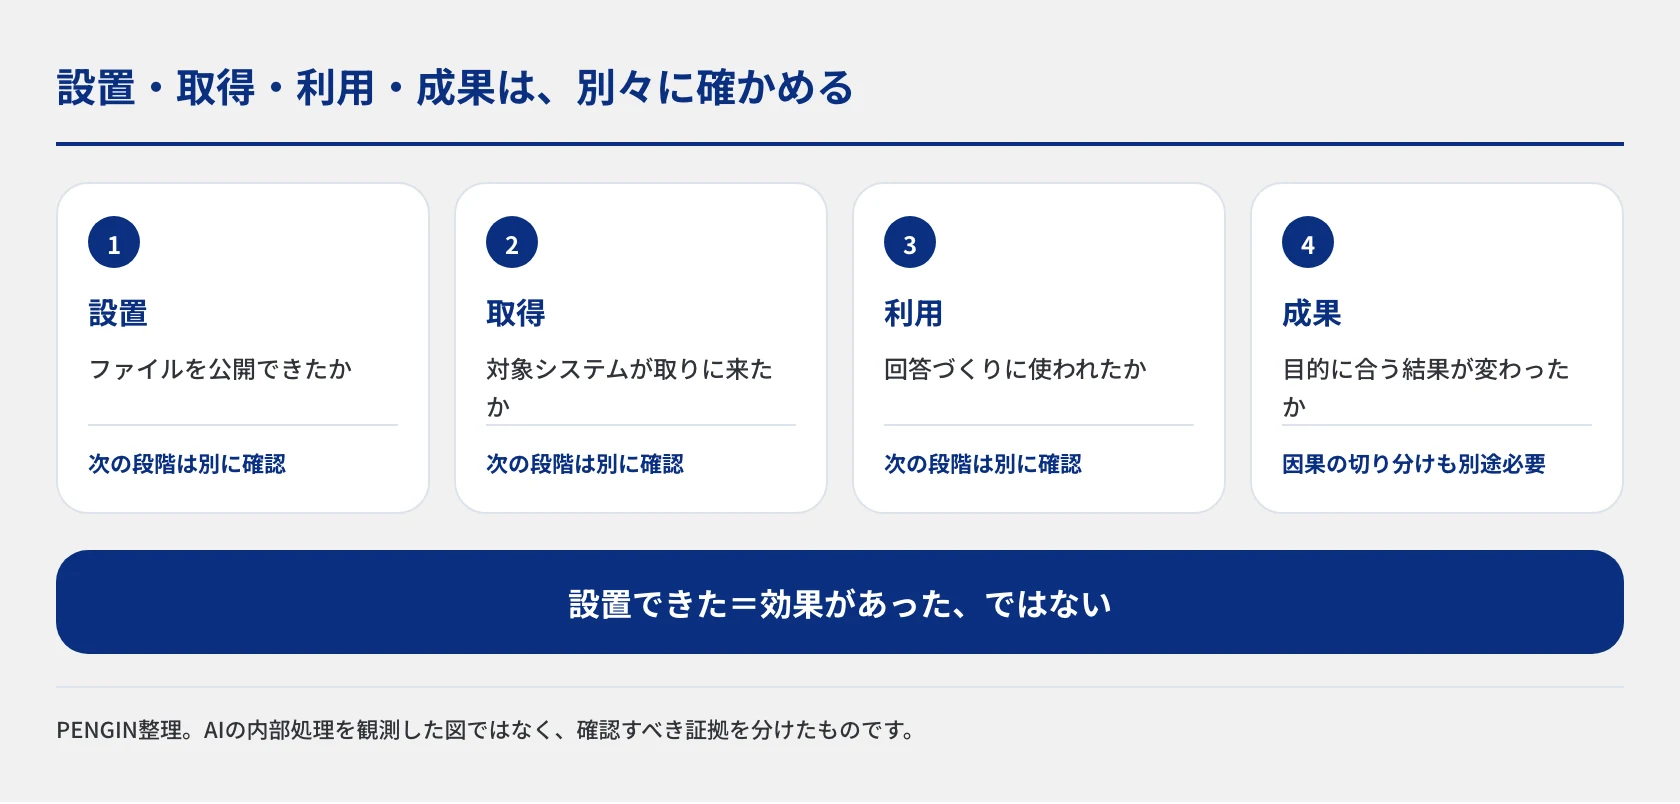
PENGINでは、llms.txtのような施策を考える際、次の4つを混同しないことを重視します。
| 段階 | 確認したいこと | それだけでは分からないこと |
|---|---|---|
| 設置 | 意図したファイルが公開され、必要な内容が書かれているか。 | 対象のAIが取得するか。 |
| 取得 | 対象のシステムによる取得を、ログや実行記録で確認できるか。 | 回答づくりに利用したか。アクセス履歴だけで利用者の真正性まで確定できるかも別。 |
| 利用 | 制御可能な環境なら、ファイルやリンク先が回答に使われた経路を確認できるか。 | 通常の検索でも得られる情報ではなかったか、引用・推薦を増やしたか。 |
| 成果 | 目的に応じた回答品質、引用、サイト訪問、有効な相談が変わったか。 | その差がllms.txtだけに起因するか。 |
この表はAIの内部処理を解明したものではなく、証拠の種類を分けるための整理です。仕組みを確認できない外部サービスでは、「利用したかは未確認」と残すことも必要です。
再検証するなら、何を先に決めるか
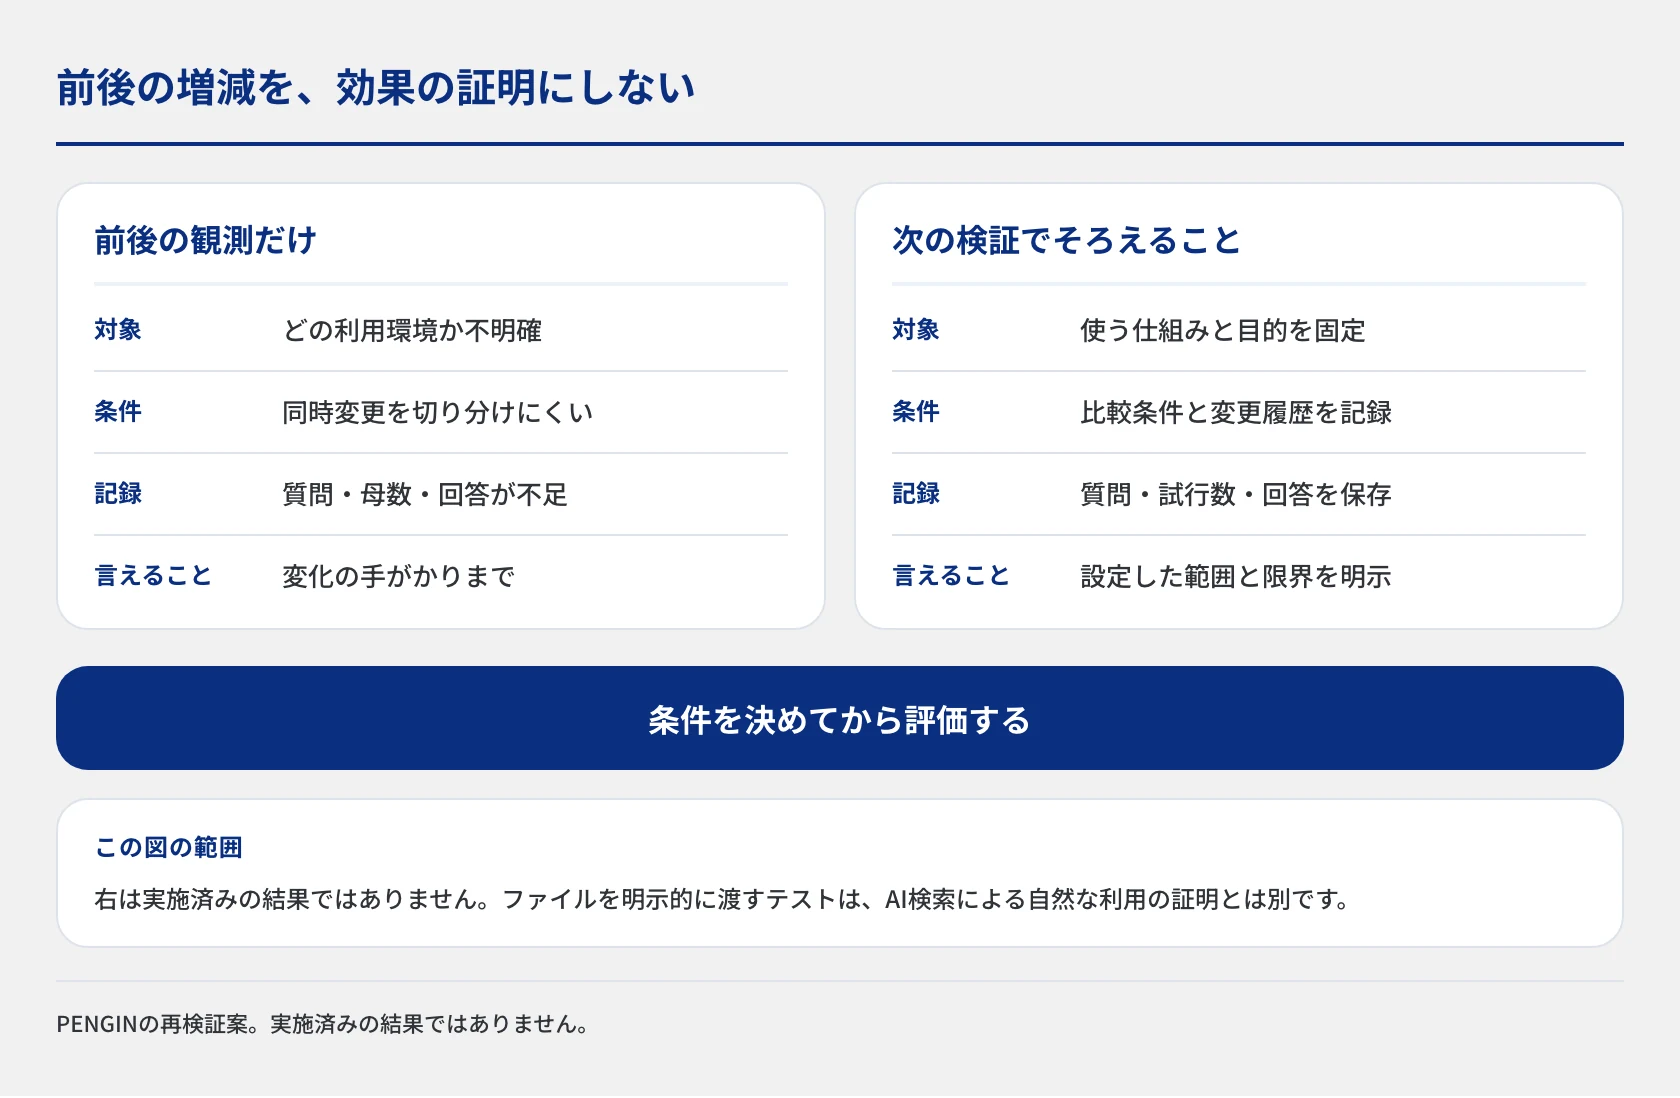
対象のサービスと、検証したい効果を固定する
まず、「特定エージェントが技術文書を探しやすくなるか」と「検索結果で引用されやすくなるか」を分けます。前者の改善が確認できても、後者まで立証したことにはなりません。
Google検索については、llms.txtを使用しないという現在の公式仕様を踏まえ、検索実績の増減をそのままファイル効果の検証としない方針です。
比較する条件と、変更してはいけない条件を残す
制御できるエージェントなら、同じ質問、同じ情報、同じ設定で、ファイルを利用する条件と利用しない条件を比べる方法を検討できます。実行順や試行回数も決め、回答の品質や必要な手間など、目的に合う評価項目を使います。
ただし、こちらからファイルを明示的に渡すテストは、「渡した場合に役立つか」の検証です。外部のAI検索が自然に発見・利用することを証明するテストにはなりません。
公開サイトの前後を観測する場合は、変更履歴と比較期間を保存し、季節性や同時施策を確認します。条件をそろえられない部分は、結論の限界として明記します。
指標と記録を、結果を見る前に決める
質問文、実施日時、利用サービスと設定、試行数、回答全文、出典URL、サイト更新履歴を残します。率を出す場合は、分子・分母と失敗・未回答の扱いも定義します。
Webへの訪問や問い合わせを追う際は、GA4を使った計測設計と診断も参考に、計測対象と成果地点をそろえます。引用、クリック、問い合わせ、受注を一つの数字に足し合わせないことが重要です。
BtoB企業では、実験より先に整える情報がないかを見る
llms.txtを試すかどうかは、実装の手軽さだけでは決めません。対象のシステムで使う目的があるか、公開してよい情報か、更新を続けられるかを確認します。
その前に、サービスの提供範囲が分からない、実績に条件が書かれていない、会社の説明がページごとに違う、といった問題があれば、PENGINではそちらを優先します。
同じ考え方はSEOにも共通します。実験的な施策を否定するのではなく、何を確かめるための実験かを定め、事業に必要な情報整備と区別することが大切です。
よくある質問
-
Q.llms.txtは削除した方がよいですか?
-
Q.過去の検証数値は誤りだったということですか?
-
Q.導入後にAI経由の問い合わせが来ても、効果とはいえませんか?
まとめ|変化を報告することと、原因を証明することは違う
過去の記事は、設置後の変化を紹介する一方で、それをllms.txtの効果と読むには必要な条件が十分ではありませんでした。現在はGoogleの公式仕様も踏まえ、対象のシステム、取得・利用の有無、成果との関係を分けて考えます。
BtoB企業の情報整備の優先順位はLLMOの基礎と実務上の対策をご覧ください。検索流入とコンテンツの見直しはSEO伴走支援、現状の課題整理はPENGINへのお問い合わせからご相談いただけます。